Hat die Ugreen denn ECC-RAM? Falls nicht, dann würde ich dem keine unternehmenskritischen Backups anvertrauen


Shared LVM gewünscht: FC-SAN?
- Thread starter sgw
- Start date
You are using an out of date browser. It may not display this or other websites correctly.
You should upgrade or use an alternative browser.
You should upgrade or use an alternative browser.
Nein, das von mir genannte NAS hat und unterstuetzt kein ECC. Ich moechte jetzt aber auch keine Diskussion lostreten, ob ECC wirklich noetig sei.Hat die Ugreen denn ECC-RAM? Falls nicht, dann würde ich dem keine unternehmenskritischen Backups anvertrauen
Wenn Du ECC brauchts, greifst Du zu der etwas teureren AMD Variante DXP4800 GT und verbaust dort zusaetzlich ECC RAM.

Ich nutze auch nur Systeme mit ECC RAM bei Kunden. Zuhause ist mir das egal.Nein, das von mir genannte NAS hat und unterstuetzt kein ECC. Ich moechte jetzt aber auch keine Diskussion lostreten, ob ECC wirklich noetig sei.
Wenn Du ECC brauchts, greifst Du zu der etwas teureren AMD Variante DXP4800 GT und verbaust dort zusaetzlich ECC RAM.

Heute Basis-Aufbau erledigt.
Bevor ich falsch abbiege: welches ZFS-Level für 4 NVMes a 960GB? Ich neige zu RAIDZ2?
Ich weiß schon, Abwägung Redundanz vs. Volumen.
Bevor ich falsch abbiege: welches ZFS-Level für 4 NVMes a 960GB? Ich neige zu RAIDZ2?
Ich weiß schon, Abwägung Redundanz vs. Volumen.
Wenn da VMs drauf sollen, Mirror.Heute Basis-Aufbau erledigt.
Bevor ich falsch abbiege: welches ZFS-Level für 4 NVMes a 960GB? Ich neige zu RAIDZ2?
Ich weiß schon, Abwägung Redundanz vs. Volumen.
RaidZ mit VMs kann man machen, aber mindestens mit Special Device Mirror und trotzdem ist die Performance deutlich schlechter als bei Mirror.
Kurz nachgerechnet: 4x 960 GB als Striped Mirror sind netto knapp 1,9 TB. Bei ZFS sollte man nicht über 80 % gehen, und Replikations-Snapshots brauchen auch noch Platz. Realistisch bleiben also so 1,4 TB für VMs. Weiter oben hattest du mal 5-8 TB netto für Phase 1 genannt. Falls das noch stimmt, reicht das einfach nicht. Dann lieber jetzt größere NVMes bestellen, solange noch nichts drauf ist. Oder war die Zahl nur fürs SAN gedacht?
Zu den Blocksizes: Fix ist eigentlich nur
Zu den Blocksizes: Fix ist eigentlich nur
ashift, und den setzt der Installer bzw. die GUI eh auf 12. Prüfen kannst du das mit zpool get ashift <pool>. Die volblocksize stellst du pro Storage ein, aber nur für neue Disks. Sollte man also vorher überlegen. Der Default von 16k passt für den normalen VM-Mix. Da würde ich nicht rumtüfteln.Wow, thanks für die schnellen Antworten ... ich breche hier mal meine Zelte ab, und mache next steps dann eher morgen früh!
Ja, irgendwo bin ich da falsch abgebogen bei den NVMes :-( ist mir auch schon aufgefallen ...Kurz nachgerechnet: 4x 960 GB als Striped Mirror sind netto knapp 1,9 TB. Bei ZFS sollte man nicht über 80 % gehen, und Replikations-Snapshots brauchen auch noch Platz. Realistisch bleiben also so 1,4 TB für VMs. Weiter oben hattest du mal 5-8 TB netto für Phase 1 genannt. Falls das noch stimmt, reicht das einfach nicht. Dann lieber jetzt größere NVMes bestellen, solange noch nichts drauf ist. Oder war die Zahl nur fürs SAN gedacht?
Zu den Blocksizes: Fix ist eigentlich nurashift, und den setzt der Installer bzw. die GUI eh auf 12. Prüfen kannst du das mitzpool get ashift <pool>. Die volblocksize stellst du pro Storage ein, aber nur für neue Disks. Sollte man also vorher überlegen. Der Default von 16k passt für den normalen VM-Mix. Da würde ich nicht rumtüfteln.
Der Pool im Mode "Mirror" wird grade überhaupt nur 960GB groß, also nur 1 von 4 Disks Volumen. Da muss ich noch mal drüber schauen.
Besser evtl morgen, heute ist die Energie schon runter.
EDIT: ich lese docs und dort "2 mirror vdevs(RAID10)" für 4 disks? Ich hatte alle 4 Disks in einen Mirror geworfen vorhin. Thx for y/n here.
Bei den NICs hab ich auch was übersehen: keine 4x 1GB on board ... also muss ich entweder Corosync oder ZFS-Replication per DAC realisieren (welches ich nicht bestellt habe).
Die ILO-Connection hab ich auf Shared NIC umgestellt, weil ich im Hinterkopf habe, dass man diese (RJ45-) NIC dann evtl auch als normale NIC entfremden kann, da muss ich noch mal kucken (EDIT: nee, dürfte nicht klappen :-( ) -> Bzw. das DAC nachbestellen.
Aktuell hab ich ein Crossconnect-Kabel auf einer separaten NIC, für die ersten Steps ohne viel Last wird das wohl reichen. Für Produktion dann natürlich extra Kabel.
erst mal danke, war ein langer Tag
EDIT 3: Cluster samt Quorum hab ich bereits am Laufen ;-)
Last edited:
Ich hab jetzt RAID10 (in "Create ZFS") genommen, mit 4x 960 GB, compression on: OK ? Gibt also in etwa 2x960GB Nutzvolumen pro Node.
Damit kann ich leben, die 5-8 TB waren fürs SAN gedacht, wenn ich erinnere.
Ich konnte auch bereits erfolgreich replizieren von Node pve1 auf pve2 etc ... sieht schon vielversprechend aus.
Danke allen!
Jetzt kommt dann noch das Verfeinern und genauere Konfigurieren dran, spätestens mit den DACs etc
Damit kann ich leben, die 5-8 TB waren fürs SAN gedacht, wenn ich erinnere.
Ich konnte auch bereits erfolgreich replizieren von Node pve1 auf pve2 etc ... sieht schon vielversprechend aus.
Danke allen!
Jetzt kommt dann noch das Verfeinern und genauere Konfigurieren dran, spätestens mit den DACs etc
Last edited:
Hach ja. Gerade fiel mir noch was auf:
Warum ich jetzt auf einmal so wenig Netto-Volumen habe? Weil ich eigentlich 6x960 GB NVMe pro Node drin stecken habe, aber nur 4x960 GB im OS erkannt werden ... und ich in Folge erstmal nur die 4 in den Pool geworfen habe.
Mit 6x wäre es mehr Platz und das hatte ich wohl auch so geplant ...
Jetzt ist die Frage: warum ist das so?
Mir wurde gesagt, dass nur die ersten 8 Slots ansprechbar sind, wenn ich nur einen CPU-Socket belegt habe, zumindest hab ich das so im Kopf, so verstanden.
Nachdem nur 6 belegt sind, sollte das ja nicht die Ursache sein.
Es ist verbaut: HP 16x 2,5" NVMe U.3 Cable Expansion Kit DL385 Gen10 Plus ... ergo sollte das auch alle Slots verkabeln.
nvme4 wurde als "hw-raid" von dem Lieferanten vorkonfiguriert, darauf ist PVE installiert.
Ich hatte die 6 NVMes beim Installieren aus den Slots gezogen, damit ich 100% auf das intern verbaute RAID aus den kleineren Disks installiere.
Ah, ich sehe meinen Fehler, denke ich. Als der Server kam, waren die Disks mit je einem Slot leer dazwischen gesteckt. Konnte ich mir nicht erklären, ich dachte, das ist vielleicht gedacht, um sie kühler zu betreiben. Ich hab sie also alle ohne Abstand neu gesteckt. Das scheint aber dazu zu führen, dass nicht alle Slots verkabelt sind. Bzw. womöglich dass der Controller das so nicht akzeptiert ohne irgendwelchen Eingriff.
Also entweder wieder hin fahren und neu stecken, oder remote in den Controller kucken?
Nun ja ;-) jetzt aber gut Nacht!
Warum ich jetzt auf einmal so wenig Netto-Volumen habe? Weil ich eigentlich 6x960 GB NVMe pro Node drin stecken habe, aber nur 4x960 GB im OS erkannt werden ... und ich in Folge erstmal nur die 4 in den Pool geworfen habe.
Mit 6x wäre es mehr Platz und das hatte ich wohl auch so geplant ...
Jetzt ist die Frage: warum ist das so?
Mir wurde gesagt, dass nur die ersten 8 Slots ansprechbar sind, wenn ich nur einen CPU-Socket belegt habe, zumindest hab ich das so im Kopf, so verstanden.
Nachdem nur 6 belegt sind, sollte das ja nicht die Ursache sein.
Es ist verbaut: HP 16x 2,5" NVMe U.3 Cable Expansion Kit DL385 Gen10 Plus ... ergo sollte das auch alle Slots verkabeln.
Code:
# dmesg | grep nvme
[    2.288060] nvme nvme0: pci function 0000:43:00.0
[    2.288677] nvme nvme1: pci function 0000:44:00.0
[    2.289224] nvme nvme2: pci function 0000:45:00.0
[    2.289822] nvme nvme3: pci function 0000:46:00.0
[    2.290357] nvme nvme4: pci function 0000:03:00.0
[    2.297947] nvme nvme4: 3/0/0 default/read/poll queues
[    2.313008] nvme nvme1: 32/0/0 default/read/poll queues
[    2.315492] nvme nvme2: 32/0/0 default/read/poll queues
[    2.317902] nvme nvme0: 32/0/0 default/read/poll queues
[    2.321020] nvme nvme3: 32/0/0 default/read/poll queues
[    2.344358]  nvme4n1: p1 p2 p3
[    6.788439] nvme nvme0: using unchecked data buffer
[ 2815.132735]  nvme0n1: p1 p9
[ 2815.284333]  nvme1n1: p1 p9
[ 2815.286252]  nvme1n1: p1 p9
[ 2815.457155]  nvme2n1: p1 p9
[ 2815.609115]  nvme3n1: p1 p9
nvme4 wurde als "hw-raid" von dem Lieferanten vorkonfiguriert, darauf ist PVE installiert.
Bash:
# lsblk
NAME                 MAJ:MIN RM   SIZE RO TYPE MOUNTPOINTS
zd0                  230:0    0     1M  0 disk
zd16                 230:16   0    16G  0 disk
├─zd16p1             230:17   0   869M  0 part
├─zd16p2             230:18   0   870M  0 part
└─zd16p3             230:19   0  14.3G  0 part
nvme0n1              259:0    0 894.3G  0 disk
├─nvme0n1p1          259:9    0 894.2G  0 part
└─nvme0n1p9          259:10   0     8M  0 part
nvme2n1              259:1    0 894.3G  0 disk
├─nvme2n1p1          259:11   0 894.2G  0 part
└─nvme2n1p9          259:12   0     8M  0 part
nvme1n1              259:2    0 894.3G  0 disk
├─nvme1n1p1          259:13   0 894.2G  0 part
└─nvme1n1p9          259:14   0     8M  0 part
nvme3n1              259:3    0 894.3G  0 disk
├─nvme3n1p1          259:15   0 894.2G  0 part
└─nvme3n1p9          259:16   0     8M  0 part
nvme4n1              259:5    0 476.9G  0 disk
├─nvme4n1p1          259:6    0  1007K  0 part
├─nvme4n1p2          259:7    0     1G  0 part /boot/efi
└─nvme4n1p3          259:8    0   475G  0 part
  ├─pve-swap         252:0    0     8G  0 lvm  [SWAP]
  ├─pve-root         252:1    0    96G  0 lvm  /
  ├─pve-data_tmeta   252:2    0   3.5G  0 lvm
  │ └─pve-data-tpool 252:4    0 347.9G  0 lvm
  │   └─pve-data     252:5    0 347.9G  1 lvm
  └─pve-data_tdata   252:3    0 347.9G  0 lvm
    └─pve-data-tpool 252:4    0 347.9G  0 lvm
      └─pve-data     252:5    0 347.9G  1 lvm
Ich hatte die 6 NVMes beim Installieren aus den Slots gezogen, damit ich 100% auf das intern verbaute RAID aus den kleineren Disks installiere.
Ah, ich sehe meinen Fehler, denke ich. Als der Server kam, waren die Disks mit je einem Slot leer dazwischen gesteckt. Konnte ich mir nicht erklären, ich dachte, das ist vielleicht gedacht, um sie kühler zu betreiben. Ich hab sie also alle ohne Abstand neu gesteckt. Das scheint aber dazu zu führen, dass nicht alle Slots verkabelt sind. Bzw. womöglich dass der Controller das so nicht akzeptiert ohne irgendwelchen Eingriff.
Also entweder wieder hin fahren und neu stecken, oder remote in den Controller kucken?
Nun ja ;-) jetzt aber gut Nacht!
Es lässt mich noch nicht los, noch 2 Beobachtungen:
Bin über ILO "ins UEFI" rein, dort sind alle 6 NVMes sichtbar, auch jetzt nach dem Umstecken. Einen zugeordneten Controller in dem Sinn finde ich da drin nicht. Auch nach Neustart danach unter Debian nur 4x nvme
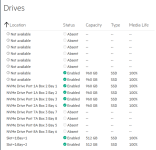
Den refurbished Servern waren Ausdrucke des ILOs bei deren Tests beigelegt, das sollte also dem Auslieferungszustand (welche Slots waren gesteckt) entsprechen. Die sehen aber auch so aus wie mein Screenshot: Location "Not available" teilweise. Vielleicht also eine falsche Spur.
Ich hab mal dort angefragt bezgl deren Aussage: "dass Sie mit nur einer CPU nie alle 16 NVMe Slots nutzen können. Dafür wären 2 CPUs nötig."
Ich hatte irgendwie geschlossen, dann gehen wohl nur 8 mit einer CPU. Ich hoffe das weiterhin ...
So wie es aussieht, ist "scaling_governor = performance" ganz schön laut, was die Lüfter betrifft ;-)
Ich erwäge, da mal andere governors zu testen. Dies nur am Rande.
Top Thema sind die "fehlenden" NVMes, da muss ich mal anrufen, denke ich. (done ...waiting)
Ich erwäge, da mal andere governors zu testen. Dies nur am Rande.
Top Thema sind die "fehlenden" NVMes, da muss ich mal anrufen, denke ich. (done ...waiting)
Last edited:
Hab mir den Screenshot angeschaut, der sagt eigentlich schon alles. iLO kennt nur 8 Bays mit Port-Zuordnung: Box 2 Bay 1-4 (Port 1A/2A) und Box 3 Bay 5-8 (Port 7A/8A). Deine 4 erkannten Disks stecken in Box 2 Bay 1-4. Die beiden anderen zeigt iLO als "Enabled" mit 960 GB, aber Location "Not available". Die stecken in Bays, an denen Strom anliegt, aber keine PCIe-Lanes. Deshalb sieht das UEFI sie, Linux nicht. Mit einer CPU sind halt nur 8 der 16 Bays angebunden.
Ich würd die zwei NVMes einfach in Box 3 Bay 5-8 stecken, die sind verkabelt und gerade leer. Vermutlich standen sie da ursprünglich. Danach sollten in
Bei HPE regelt das eher das BIOS als der Governor. Schau mal in Workload Profile und Thermal Configuration, da macht "Optimal Cooling" oft mehr Unterschied.
Ich würd die zwei NVMes einfach in Box 3 Bay 5-8 stecken, die sind verkabelt und gerade leer. Vermutlich standen sie da ursprünglich. Danach sollten in
lsblk 6 Disks auftauchen. Die zwei kriegst du so in den Pool: zpool add <pool> mirror /dev/disk/by-id/... /dev/disk/by-id/.... Nimm die by-id-Pfade, nicht nvmeXn1. Wenn der Pool schon Daten hat, verteilt ZFS diese nicht neu. Wenn der Pool noch quasi leer ist, würd ich ihn aber lieber neu mit 3 Mirrors anlegen.Bei HPE regelt das eher das BIOS als der Governor. Schau mal in Workload Profile und Thermal Configuration, da macht "Optimal Cooling" oft mehr Unterschied.
Optimal Cooling ist drin, Fans laufen dann so rund um 50% laut ILO.
CPU governor "ondemand" hat da nicht viel geändert (ich hab jemanden vor Ort in den Raum geschickt, der den Vergleich hat von vorher).
Das mit den Boxen und Bays leuchtet mir ein und stimmt mich hoffnungsvoll ;-)
Aktuell sind alle 6 in Box2, soweit ich die Box-Bezeichnung aus den QuickSpecs raus lese.
Du meinst "Deine 4 erkannten Disks stecken in Box 2 Bay 1-4", ja, und Bay 5 und 6 sind auch belegt, aber nicht im OS erkannt.
Ergo würde ich die 2 umstecken lassen ...
Der Pool ist mir noch egal, den kann ich auch neu erstellen, noch ist da nix Relevantes drin.
Danke ... ich denke, ich werd da gleich noch mal anrufen beim Kunden (bin heute nicht dort).
> Wenn der Pool noch quasi leer ist, würd ich ihn aber lieber neu mit 3 Mirrors anlegen
Jetzt wisst Ihr eh schon, dass ich hilflos bin daher an dieser Stelle lieber noch mal deutlich nachgefragt, bevor ich dann Jahre mit einer schlechten Entscheidung leben muss:
Den Pool lieber auf der Shell erstellen?
3x mirror aus 2 Disks? und dann daraus RAID10?
Ich lese https://pve.proxmox.com/wiki/ZFS_on_Linux#_zfs_administration und tendiere zum Beispiel "Create a new pool with RAID-10" ... nur halt mit einem dritten Mirror.
Jetzt wisst Ihr eh schon, dass ich hilflos bin
daher an dieser Stelle lieber noch mal deutlich nachgefragt, bevor ich dann Jahre mit einer schlechten Entscheidung leben muss:Den Pool lieber auf der Shell erstellen?
3x mirror aus 2 Disks? und dann daraus RAID10?
Ich lese https://pve.proxmox.com/wiki/ZFS_on_Linux#_zfs_administration und tendiere zum Beispiel "Create a new pool with RAID-10" ... nur halt mit einem dritten Mirror.
Schau mal in Workload Profile und Thermal Configuration, da macht "Optimal Cooling" oft mehr Unterschied.Workload Profile war auf "General Power Efficient Compute", ich versuche auf einem der Nodes nun mal "Virtualization - Power Efficient" ... (das fand ich nur im BIOS, nicht im ILO, btw).
Sieht für mich nach Standard Verkabelung aus, da sind immer nur die ersten 4 Slots mit PCIe angeschlossen. Schau mal ob auch ein zweites Kabel an der backplane hängt für die zweiten 4 Slots.Hach ja. Gerade fiel mir noch was auf:
Warum ich jetzt auf einmal so wenig Netto-Volumen habe? Weil ich eigentlich 6x960 GB NVMe pro Node drin stecken habe, aber nur 4x960 GB im OS erkannt werden ... und ich in Folge erstmal nur die 4 in den Pool geworfen habe.
Mit 6x wäre es mehr Platz und das hatte ich wohl auch so geplant ...
Jetzt ist die Frage: warum ist das so?
Mir wurde gesagt, dass nur die ersten 8 Slots ansprechbar sind, wenn ich nur einen CPU-Socket belegt habe, zumindest hab ich das so im Kopf, so verstanden.
Nachdem nur 6 belegt sind, sollte das ja nicht die Ursache sein.
Es ist verbaut: HP 16x 2,5" NVMe U.3 Cable Expansion Kit DL385 Gen10 Plus ... ergo sollte das auch alle Slots verkabeln.
Code:# dmesg | grep nvme [ 2.288060] nvme nvme0: pci function 0000:43:00.0 [ 2.288677] nvme nvme1: pci function 0000:44:00.0 [ 2.289224] nvme nvme2: pci function 0000:45:00.0 [ 2.289822] nvme nvme3: pci function 0000:46:00.0 [ 2.290357] nvme nvme4: pci function 0000:03:00.0 [ 2.297947] nvme nvme4: 3/0/0 default/read/poll queues [ 2.313008] nvme nvme1: 32/0/0 default/read/poll queues [ 2.315492] nvme nvme2: 32/0/0 default/read/poll queues [ 2.317902] nvme nvme0: 32/0/0 default/read/poll queues [ 2.321020] nvme nvme3: 32/0/0 default/read/poll queues [ 2.344358] nvme4n1: p1 p2 p3 [ 6.788439] nvme nvme0: using unchecked data buffer [ 2815.132735] nvme0n1: p1 p9 [ 2815.284333] nvme1n1: p1 p9 [ 2815.286252] nvme1n1: p1 p9 [ 2815.457155] nvme2n1: p1 p9 [ 2815.609115] nvme3n1: p1 p9
nvme4 wurde als "hw-raid" von dem Lieferanten vorkonfiguriert, darauf ist PVE installiert.
Bash:# lsblk NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINTS zd0 230:0 0 1M 0 disk zd16 230:16 0 16G 0 disk ├─zd16p1 230:17 0 869M 0 part ├─zd16p2 230:18 0 870M 0 part └─zd16p3 230:19 0 14.3G 0 part nvme0n1 259:0 0 894.3G 0 disk ├─nvme0n1p1 259:9 0 894.2G 0 part └─nvme0n1p9 259:10 0 8M 0 part nvme2n1 259:1 0 894.3G 0 disk ├─nvme2n1p1 259:11 0 894.2G 0 part └─nvme2n1p9 259:12 0 8M 0 part nvme1n1 259:2 0 894.3G 0 disk ├─nvme1n1p1 259:13 0 894.2G 0 part └─nvme1n1p9 259:14 0 8M 0 part nvme3n1 259:3 0 894.3G 0 disk ├─nvme3n1p1 259:15 0 894.2G 0 part └─nvme3n1p9 259:16 0 8M 0 part nvme4n1 259:5 0 476.9G 0 disk ├─nvme4n1p1 259:6 0 1007K 0 part ├─nvme4n1p2 259:7 0 1G 0 part /boot/efi └─nvme4n1p3 259:8 0 475G 0 part ├─pve-swap 252:0 0 8G 0 lvm [SWAP] ├─pve-root 252:1 0 96G 0 lvm / ├─pve-data_tmeta 252:2 0 3.5G 0 lvm │ └─pve-data-tpool 252:4 0 347.9G 0 lvm │ └─pve-data 252:5 0 347.9G 1 lvm └─pve-data_tdata 252:3 0 347.9G 0 lvm └─pve-data-tpool 252:4 0 347.9G 0 lvm └─pve-data 252:5 0 347.9G 1 lvm
Ich hatte die 6 NVMes beim Installieren aus den Slots gezogen, damit ich 100% auf das intern verbaute RAID aus den kleineren Disks installiere.
Ah, ich sehe meinen Fehler, denke ich. Als der Server kam, waren die Disks mit je einem Slot leer dazwischen gesteckt. Konnte ich mir nicht erklären, ich dachte, das ist vielleicht gedacht, um sie kühler zu betreiben. Ich hab sie also alle ohne Abstand neu gesteckt. Das scheint aber dazu zu führen, dass nicht alle Slots verkabelt sind. Bzw. womöglich dass der Controller das so nicht akzeptiert ohne irgendwelchen Eingriff.
Also entweder wieder hin fahren und neu stecken, oder remote in den Controller kucken?
Nun ja ;-) jetzt aber gut Nacht!
View attachment 100332