Verständnisfrage ZFS Quota (Storage voll) - Kein GC möglich

mhert

Well-Known Member
Jul 5, 2017
136
8
83
46
Hallo zusammen.

Ich habe momentan (mal wieder) das Problem, daß der Backupstorage voll ist. Beim ersten Mal habe ich dann

a) ein Quota eingerichtet, damit ich das im Notfall kurzzeitig erhöhen kann, um GC zu ermöglichen
b) eine leere Datei (25GB?) auf dem Storage angelegt, als einfachere Lösung (Datei löschen oder verschieben, GC durchzuführen, Datei mit dd anlegen oder zurückschieben)

Nun habe ich (wie schon einmal) Variante b) durchführen wollen, aber nach Löschen der Datei (rm dateiname) sind immer noch 100%
Speicherplatz belegt?! Muss ich den Server dran erinnern, daß da eigentlich Platz frei sein sollte?

Also Variante a) durchführen wollen (auch schon mal erfolgreich gemacht), aber da ändert sich ebenfalls nichts...

Handelt es sich um ein Verständnisproblem meinerseits, oder habe ich den falschen Befehl ausgeführt? Wie kann ich kurzzeitig ein paar Gigabyte freien Speicherplatz schaffen?

root@bk01:~# zpool list local_backupstorage_bk01
NAME SIZE ALLOC FREE CKPOINT EXPANDSZ FRAG CAP DEDUP HEALTH ALTROOT
local_backupstorage_bk01 14.5T 14.4T 126G - - 81% 99% 1.00x ONLINE -

root@bk01:~# zfs list local_backupstorage_bk01
NAME USED AVAIL REFER MOUNTPOINT
local_backupstorage_bk01 14.4T 0B 14.4T /mnt/datastore/local_backupstorage_bk01

root@bk01:~# zfs set quota=14.5T local_backupstorage_bk01

root@bk01:~# zfs list local_backupstorage_bk01
NAME USED AVAIL REFER MOUNTPOINT
local_backupstorage_bk01 14.4T 0B 14.4T /mnt/datastore/local_backupstorage_bk01

root@bk01:~#


Gruß, Oli
 
hi,
es gibt im Proxmox Forum bereits einen sehr ähnlichen Fall, der genau zu deinen Beobachtungen passt:

ZFS Pool "backup" 100% Full, GC fails

Vielleicht hilft dir der Post ja weiter, falls nicht, können wir uns das hier auch noch im Detail anschauen.
 
Ja. Jetzt habe ich auch den Hintergrund dazu verstanden...

Und ich hatte in meiner Doku auch einen Denkfehler (Copy/Paste-Fehler?) drin. Ich hatte mir das mal von irgendwoher kopiert
und der Fehler findet sich in Zeile 2:

cat /sys/module/zfs/parameters/spa_slop_shift # maybe it's 5 or 3
echo 2 > /sys/module/zfs/parameters/spa_slop_shift
Carry out Garbage Collection and then set back the zfs parameter to orig value.

2 ist natürlich Quatsch, da er hierbei noch mehr Platz reserviert als bei 5 (was eingestellt war)

Nachdem ich den Wert auf 9 (bei 6 änderte sich nichts oder ich war zu ungeduldig) geändert habe, hatte ich plötzlich knapp 30 GB freien Speicher-
platz und kann GC nun durchführen.

Danke für die Hilfe.
 
  • Like
Reactions: waltar
Warum sich die Löschung der Platzhalterdatei allerdings nicht ausgewirkt hat, ist mir schleierhaft.

Konnte sie nicht gelöscht werden, weil Volume voll? Sie war aber definitv weg nach "rm" in der Console...
 
Eine Anmerkung noch an die "Macher" von PBS.

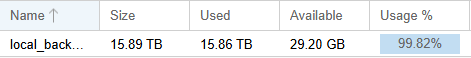
Sollten die Angaben hier dann nicht angepaßt werden, da ja eigentlich nichts "Available" ist, sondern hier nur der "spa_slop_shift" angezeigt wird (hier
von 5 auf 9 geändert):

1794582075848.png
 
Warum sich die Löschung der Platzhalterdatei allerdings nicht ausgewirkt hat, ist mir schleierhaft.

Konnte sie nicht gelöscht werden, weil Volume voll? Sie war aber definitv weg nach "rm" in der Console...

Aus der ZFS Dokumentation:

When any setting except off is selected, compression will explicitly check for blocks consisting of only zeroes (the NUL byte). When a zero-filled block is detected, it is stored as a hole and not compressed using the indicated compression algorithm.​

ZFS detektiert also reine 0-Blöcke und speichert diese als sogenanntes "Loch", sprich es wurden physisch nie 25GB auf der Disk allokiert, weshalb beim Löschen der Datei auch fast kein Speicher wieder freigegeben wurde, siehe ZFS Dokumentation.

Sollten die Angaben hier dann nicht angepaßt werden, da ja eigentlich nichts "Available" ist, sondern hier nur der "spa_slop_shift" angezeigt wird (hier
von 5 auf 9 geändert):

An sich macht diese Anzeige schon Sinn. Ein einziger ZFS-Pool kann ja mehrere Datasets (und damit auch mehrere PBS-Datastores) beinhalten. Zum Beispiel:
Code:
root@pbs-node-9:~# zfs list
NAME               USED  AVAIL  REFER  MOUNTPOINT
testpool          49.1M  15.0G   104K  /mnt/datastore/testpool
testpool/store1   24.3M  4.98G  24.3M  /mnt/datastore/testpool/store1
testpool/store2   24.3M  15.0G  24.3M  /mnt/datastore/testpool/store2

'zfs list' zeigt hier die gleichen Werte wie auch die Datastore Summary Seite in der WebUI. In diesem Fall hab ich für store1 hier ein ~5G Quota gesetzt. Wenn dieser Datastore voll ist, meldet er also "0B Available" und nimmt keine Backups mehr an.

Code:
root@pbs-node-9:~# zpool list
NAME       SIZE  ALLOC   FREE  CKPOINT  EXPANDSZ   FRAG    CAP  DEDUP    HEALTH  ALTROOT
testpool  15.5G  49.1M  15.5G        -         -     0%     0%  1.00x    ONLINE  -

In der WebUI unter "Disks -> ZFS" wird 'zpool list' abgefragt. Wenn store1 bei 100% steht, ist es wichtig auf einen Blick sehen zu können, ob die physischen Festplatten (testpool) darunter noch Platz haben, damit z. B. store2 und die interne ZFS-Reserve weiterhin funktionieren. Würde die globale Pool-Ansicht einfach "0" anzeigen, sobald das erste Dataset (oder der Slop-Space) voll ist, hätte man keinen Überblick mehr über den eigentlichen Füllstand der physikalischen Disks.
 
also mit dd random inhalte erzeugen...

Befehl "zfs" bezieht sich auf Volume-Ebene, richtig?
 
Abschließende Frage: Wieso lassen sich beim Volllaufen keine Löschungen mehr durchführen, wenn automatisch ein Bereich für Dateisystemoperationen
reserviert ist (slope)?

Oder funktioniert "normales" löschen generell, aber eben kein GC (weil zusätzliche Daten geschrieben werden)?
 
so habe ich es in deiner Situation gelöst:

Like you said, you are not able to run GC, because you have no disk space left. Let us change that.
Get another disk. Does not matter if USB or SATA. Probably even a usb stick would work. Move some chunks off the pool, run Garbage Collect, move them back onto the pool. Easy.

- replace poolBackup with your pool name
- replace /mnt/datastore/poolBackup/.chunks/aaa* with the path to your chunk files
- replace /tmp with the path to your external disk or wherever you move your files.

This is how it is done:

- move some chunk file folders (names starting with aaa) off the pool, onto your external disk. This should only take a few seconds, since it is only a few hundred MB.
mv /mnt/datastore/poolBackup/.chunks/aaa* /tmp/
- run the Garbage Collect Job. Don't worry about the errors, it will detect that you moved some files.
- move the folders back onto the pool
mv /tmp/aaa* /mnt/datastore/poolBackup/.chunks/
- run Garbage Collect again. This time there should not be any errors
- create a yearly verify job that does not skip already verfied chunks
- run that verfy job
- delete that job
- set a zfs quota by
zfs set quota=1.8T poolBackup
 
Das mit Quota hat einmal funktioniert bei mir und beim 2ten Mal nicht mehr.

Allerdings vermute ich hierbei, daß ich den Quota nach dem ersten Mal nicht mehr zurückgesetzt habe und daher die Platte beim 2ten Mail wirklich
voll war... ;)

Ich habe es nun mit "reservation" gelöst und hoffe es funktioniert dann auch... oder die Platte läuft nie wieder voll > unwahrscheinlich. :rolleyes:

Das mit der leeren Datei, die gar nicht existiert, ist ne ganz schöne "Verarsche" am User und genau das, was man braucht, wenn nix mehr geht... :eek::D
 
Ah. Vielleicht noch als abschließende Frage:

Eine Änderung an "spa_slop_shift" wird generell durch Reboot zurückgesetzt? Oder kann man das dauerhaft setzen?