

Seit Update auf Proxmox 9.2 Backup und Replication sehr träge

Adi M

Well-Known Member
Mar 1, 2020
44
3
48
54
Ich habe mehrere HP Gen8 Server mit mehreren 1G-Netzwerkanschlüsse.

Nach längerem habe ich wieder ein Update gemacht und ist jetzt auf 9.2.20
Seither habe ich massiv Netzwerkprobleme, was sich auch schon in Pulk-Start geäussert hat.

Ausgangslage:
  • nic0, nic1, nic3 sind UP → drei physische Ports aktiv.
  • nic2 ist DOWN.
  • vmbr0 hat 10.16.50.10/24
  • vmbr4 hat 10.16.100.10/24
  • vmbr1 hat keine IPv4-Adresse -> VM/CT-Netzwerk.
  • alle drei Leitungen haben getrennte Switch

Aktueller Aufbau​

VerkehrNetzwerkPhysisches Interface
Corosync10.16.50.0/24nic0 / vmbr0
Management/Gateway10.16.50.0/24nic0 / vmbr0
VM-NetzLayer 2nic1 / vmbr1
Backup10.16.100.0/24nic3 / vmbr4
ZFS-Replication10.16.100.0/24nic3 / vmbr4

Was spannend ist: der eigentliche Netzwerkdurchsatz scheint unauffällig zu sein:
:~# iperf3 -c 10.16.100.11
Connecting to host 10.16.100.11, port 5201
[ 5] local 10.16.100.10 port 33594 connected to 10.16.100.11 port 5201
[ ID] Interval Transfer Bitrate Retr Cwnd
[ 5] 0.00-1.00 sec 114 MBytes 956 Mbits/sec 0 414 KBytes
[ 5] 1.00-2.00 sec 112 MBytes 940 Mbits/sec 0 414 KBytes
[ 5] 2.00-3.00 sec 113 MBytes 947 Mbits/sec 0 444 KBytes
[ 5] 3.00-4.00 sec 96.6 MBytes 811 Mbits/sec 0 472 KBytes
[ 5] 4.00-5.00 sec 112 MBytes 937 Mbits/sec 0 499 KBytes
[ 5] 5.00-6.00 sec 113 MBytes 946 Mbits/sec 0 499 KBytes
[ 5] 6.00-7.00 sec 112 MBytes 940 Mbits/sec 0 499 KBytes
[ 5] 7.00-8.00 sec 107 MBytes 900 Mbits/sec 0 499 KBytes
[ 5] 8.00-9.00 sec 86.8 MBytes 728 Mbits/sec 0 499 KBytes
[ 5] 9.00-10.00 sec 112 MBytes 938 Mbits/sec 0 499 KBytes
- - - - - - - - - - - - - - - - - - - - - - - - -
[ ID] Interval Transfer Bitrate Retr
[ 5] 0.00-10.00 sec 1.05 GBytes 904 Mbits/sec 0 sender
[ 5] 0.00-10.00 sec 1.05 GBytes 902 Mbits/sec receiver

iperf Done.
----------------------------------------------

Aber in der Praxix läufft seit Update das Backup seht lange mit gefühlt Faktor 1000. Eine einfache Maschine:
INFO: processed 3.226 GiB in 11h 10m 0.8s, uploaded 722.48 MiB

Ich bekomme seit Update auch viele "ERROR: can't acquire lock '/var/run/vzdump.lock' - got timeout" Meldungen bei Backup und Migration.
Auch hängt sich Replikation des öffters, sodass ich es mit "pvesr delete <VM-ID>-<INDEX> --force" abbrechen muss.

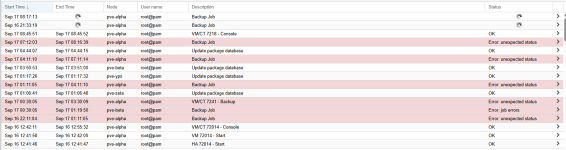
Ich habe den Eindruck, dass sich Backup-Prozesse und Replikation-Prozesse untereinander und gegeneinander blockieren.

1789628281917.png

1789628328246.png
 
Das Netzwerk würd ich nach dem iperf3 erstmal ausklammern. 3,2 GiB gelesen in 11h und davon nur 722 MiB hochgeladen heisst ja: der Upload ist gar nicht der Flaschenhals, er kommt beim Lesen nicht voran. Riecht stark nach Storage/IO, nicht nach Netz.

Schau mal mit zpool status auf den Nodes, ob da ein Scrub oder Resilver läuft. Nach dem Update-Reboot ist das der Klassiker und drückt genau so den Durchsatz weg. Und während ein Backup läuft mal zpool iostat -v 5 bzw. iostat -x 5 mitlaufen lassen, plus das IO-Delay in der Node-Summary.

Die vzdump.lock-Timeouts und die hängende Replikation sind wohl Folgefehler. Solange das eine Backup 11h blockiert, kommt der nächste Job nicht ans Lock und die Replikation stolpert über die Snapshots. Würd erstmal die Leserate anschauen, der Rest sollte sich dann klären.

Was hängt bei den Gen8 an Platten/Controller dran, P420 im RAID oder HBA-Mode? Und liegt der PBS-Datastore zufällig auf denselben Spindeln wie die VMs?
 
Nachtrag:
Nach dem ich mit "pvesr delete <VM-ID>-<INDEX> --force" die hängengebliebene Replikation gestoppt habe, läuft das Backup auch wieder viel besser.
 
Das Netzwerk würd ich nach dem iperf3 erstmal ausklammern. 3,2 GiB gelesen in 11h und davon nur 722 MiB hochgeladen heisst ja: der Upload ist gar nicht der Flaschenhals, er kommt beim Lesen nicht voran. Riecht stark nach Storage/IO, nicht nach Netz.

Schau mal mit zpool status auf den Nodes, ob da ein Scrub oder Resilver läuft. Nach dem Update-Reboot ist das der Klassiker und drückt genau so den Durchsatz weg. Und während ein Backup läuft mal zpool iostat -v 5 bzw. iostat -x 5 mitlaufen lassen, plus das IO-Delay in der Node-Summary.

Die vzdump.lock-Timeouts und die hängende Replikation sind wohl Folgefehler. Solange das eine Backup 11h blockiert, kommt der nächste Job nicht ans Lock und die Replikation stolpert über die Snapshots. Würd erstmal die Leserate anschauen, der Rest sollte sich dann klären.

Was hängt bei den Gen8 an Platten/Controller dran, P420 im RAID oder HBA-Mode? Und liegt der PBS-Datastore zufällig auf denselben Spindeln wie die VMs?
Danke für die Rückmeldung
Die Platten habe ich im HBA-Modus und führe sie mit ZFS als Raid zusammen.
Auf der Maschine mit Backup sind es 3 Platten für Proxmox und seppariert 5 Platten für Backup.
Insbesondere ist das Replikationsziel eine andere Knote als das Backup.

~# zpool status
Code:
pool: rpool
 state: DEGRADED
status: One or more devices are faulted in response to persistent errors.
        Sufficient replicas exist for the pool to continue functioning in a
        degraded state.
action: Replace the faulted device, or use 'zpool clear' to mark the device
        repaired.
  scan: scrub repaired 6.98M in 01:05:11 with 0 errors on Sun Sep 13 01:29:12 2026
config:

        NAME                                              STATE     READ WRITE CKSUM
        rpool                                             DEGRADED     0     0     0
          raidz3-0                                        DEGRADED     0     0     0
            scsi-3600508b1001c528c4e48ffbac82ec84d-part3  ONLINE       0     0     0
            scsi-3600508b1001ce04e4d04eb8fdbdc746d-part3  ONLINE       0     0     0
            scsi-3600508b1001c78d53971a89557ab4cd4-part3  ONLINE       0     0     0
            scsi-3600508b1001cc06fdfb846c3ab810ec3-part3  ONLINE       0     0     0
            scsi-3600508b1001c4a6a443d5a83319a052f-part3  ONLINE       0     0     0
            sdf3                                          FAULTED      0     0     0  too many errors
            scsi-3600508b1001ca1150741985bb8d236fd-part3  ONLINE       0     0     0
            scsi-3600508b1001cd62ec80f78134ee22bde-part3  ONLINE       0     0     0

errors: No known data errors

Wobei sdf3 FAULTED neu ist.

~# zpool iostat -v 5
Code:
capacity     operations     bandwidth
pool                                    alloc   free   read  write   read  write
--------------------------------------  -----  -----  -----  -----  -----  -----
rpool                                    732G  1.44T     60    297   711K  3.96M
  raidz3-0                               732G  1.44T     60    297   711K  3.96M
    scsi-3600508b1001c528c4e48ffbac82ec84d-part3      -      -      8     44   1                                                                                                                        17K   595K
    scsi-3600508b1001ce04e4d04eb8fdbdc746d-part3      -      -      6     42   1                                                                                                                        07K   586K
    scsi-3600508b1001c78d53971a89557ab4cd4-part3      -      -      6     42  99                                                                                                                        .5K   576K
    scsi-3600508b1001cc06fdfb846c3ab810ec3-part3      -      -     16     40   1                                                                                                                        41K   562K
    scsi-3600508b1001c4a6a443d5a83319a052f-part3      -      -      5     44  60                                                                                                                        .7K   595K
    sdf3                                    -      -      0      0      0      0
    scsi-3600508b1001ca1150741985bb8d236fd-part3      -      -      2     42  42                                                                                                                        .9K   577K
    scsi-3600508b1001cd62ec80f78134ee22bde-part3      -      -     15     41   1                                                                                                                        42K   564K
--------------------------------------  -----  -----  -----  -----  -----  -----
                                                    capacity     operations     bandwidth
pool                                              alloc   free   read  write   read  write
------------------------------------------------  -----  -----  -----  -----  -----  -----
rpool                                              732G  1.44T     18    271  73.5K  4.42M
  raidz3-0                                         732G  1.44T     18    271  73.5K  4.42M
    scsi-3600508b1001c528c4e48ffbac82ec84d-part3      -      -      5     37  22.4K   661K
    scsi-3600508b1001ce04e4d04eb8fdbdc746d-part3      -      -      1     40  5.59K   651K
    scsi-3600508b1001c78d53971a89557ab4cd4-part3      -      -      0     38    817   644K
    scsi-3600508b1001cc06fdfb846c3ab810ec3-part3      -      -      2     35  12.0K   638K
    scsi-3600508b1001c4a6a443d5a83319a052f-part3      -      -      0     41  3.99K   670K
    sdf3                                              -      -      0      0      0      0
    scsi-3600508b1001ca1150741985bb8d236fd-part3      -      -      0     39      0   656K
    scsi-3600508b1001cd62ec80f78134ee22bde-part3      -      -      7     38  28.7K   610K
------------------------------------------------  -----  -----  -----  -----  -----  -----
 
Last edited:
Das Netzwerk würd ich nach dem iperf3 erstmal ausklammern. 3,2 GiB gelesen in 11h und davon nur 722 MiB hochgeladen heisst ja: der Upload ist gar nicht der Flaschenhals, er kommt beim Lesen nicht voran. Riecht stark nach Storage/IO, nicht nach Netz.

Schau mal mit zpool status auf den Nodes, ob da ein Scrub oder Resilver läuft. Nach dem Update-Reboot ist das der Klassiker und drückt genau so den Durchsatz weg. Und während ein Backup läuft mal zpool iostat -v 5 bzw. iostat -x 5 mitlaufen lassen, plus das IO-Delay in der Node-Summary.

Die vzdump.lock-Timeouts und die hängende Replikation sind wohl Folgefehler. Solange das eine Backup 11h blockiert, kommt der nächste Job nicht ans Lock und die Replikation stolpert über die Snapshots. Würd erstmal die Leserate anschauen, der Rest sollte sich dann klären.

Was hängt bei den Gen8 an Platten/Controller dran, P420 im RAID oder HBA-Mode? Und liegt der PBS-Datastore zufällig auf denselben Spindeln wie die VMs?
Irgend etwas am Netzwerk erscheint mir sehreigenartig:

...
INFO: processed 9.628 GiB in 1h 6m 0.1s, uploaded 145.689 MiB
INFO: processed 9.628 GiB in 1h 7m 0.1s, uploaded 145.689 MiB
INFO: processed 9.628 GiB in 1h 8m 0.1s, uploaded 145.689 MiB
INFO: processed 9.628 GiB in 1h 9m 0.1s, uploaded 145.689 MiB
INFO: processed 13.089 GiB in 1h 10m 0.1s, uploaded 524.74 MiB
INFO: processed 13.957 GiB in 1h 11m 0.1s, uploaded 557.518 MiB
INFO: processed 14.057 GiB in 1h 12m 0.1s, uploaded 577.669 MiB
...
INFO: processed 26.639 GiB in 1h 23m 0.2s, uploaded 577.669 MiB
INFO: processed 26.639 GiB in 1h 24m 0.2s, uploaded 577.669 MiB
INFO: processed 30.828 GiB in 1h 25m 0.2s, uploaded 1.07 GiB
INFO: processed 38.916 GiB in 1h 26m 0.2s, uploaded 1.095 GiB
INFO: processed 39.201 GiB in 1h 27m 0.2s, uploaded 1.113 GiB
...
INFO: processed 39.201 GiB in 2h 8m 0.2s, uploaded 1.113 GiB
INFO: processed 39.201 GiB in 2h 9m 0.2s, uploaded 1.113 GiB
INFO: processed 39.585 GiB in 2h 10m 0.2s, uploaded 1.526 GiB
INFO: processed 40.002 GiB in 2h 11m 0.2s, uploaded 1.551 GiB
INFO: processed 40.18 GiB in 2h 12m 0.2s, uploaded 1.551 GiB
INFO: processed 41.702 GiB in 2h 13m 0.2s, uploaded 1.551 GiB
INFO: processed 46.88 GiB in 2h 14m 0.2s, uploaded 1.551 GiB
INFO: processed 47.099 GiB in 2h 15m 0.2s, uploaded 1.551 GiB
...