GC auf lokalem Storage dauert länger als auf NAS?

mhert

Well-Known Member
Jul 5, 2017
127
7
83
46
Hallo zusammen.

Wir haben im PBS-Server (eigene VM auf PVE) 2 durchgereichte HDD's mit 16TB im ZFS-Verbund als lokalen Backupspeicher eingerichtet. Ist keine Rakete (GC und Verify), funktioniert aber eigentlich ganz gut.

Außerdem haben wir einen ähnlich großen Speicherpool auf einem NAS, auf welchen die Backups vom lokalen Storage täglich repliziert werden (PBS Sycn Job). Auch mit dieser
Leistung sind wir zufrieden.

Was aber merkwürdig ist in meinen Augen:

Die GC auf dem lokalen Storage dauert wesentlich länger als die GC auf dem NAS. Da wir letzte Woche kurz vor Speicherlimit waren, habe ich alle anderen Aktionen gestoppt und auf beiden Storages eine GC gestartet. Hier mal die Laufzeit:

1793782704935.png

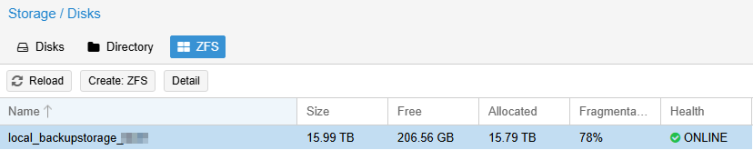
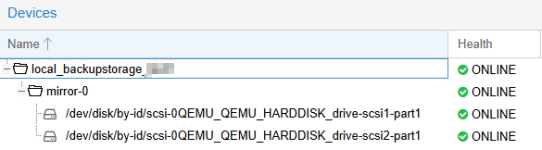
Details zum Speicher:

1793784071457.png

1793784026043.png

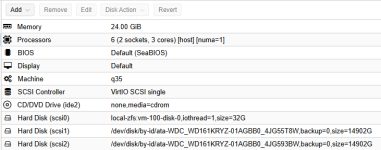
Hier die Platten in der VM-Konfiguration auf dem Host:
1793785210554.png


An welcher Stelle wäre hier nach Optimierungspotential beim lokalen Storage zu suchen (ohne Hardwareeingriff)?


Gruß, Oli
 
Hm, auf deinen Screenshots sehe ich vor allem zwei Sachen: Der Pool ist mit 206 GB frei von 16 TB praktisch voll (~99 %), dazu 78 % Fragmentierung. Ab ca. 80 % Füllstand wird ZFS spürbar langsamer, kurz vor voll bricht die Performance richtig ein, weil es kaum noch zusammenhängende freie Bereiche findet. Die GC ist bei PBS reine Random-IO. In Phase 1 wird bei jedem referenzierten Chunk die atime angefasst, und ein Mirror aus zwei HDDs hat dafür halt nur die IOPS von ungefähr einer Platte. Mit dem Füllstand und der Fragmentierung sind 47h nicht wirklich überraschend.

Ohne neue Hardware würde ich erst Platz machen, also die Retention auf dem lokalen Datastore runterschrauben. Den langen Verlauf hast du ja eh auf dem NAS, da gehört der hin. Danach prune + GC laufen lassen und den Pool dauerhaft unter 80 % halten. Noch ne Kleinigkeit: scsi1/scsi2 haben im Gegensatz zu scsi0 kein iothread=1, das würde ich noch nachziehen. Ist aber nicht die Hauptursache. Die atime im Pool bitte NICHT abschalten, die GC braucht sie.

Welche PBS-Version läuft bei euch? Seit 3.4 gibt es einen Cache für die atime-Updates der GC (gc-cache-capacity in den Tuning-Optionen vom Datastore), der doppelte Zugriffe auf Chunks spart. Und was steckt im NAS an Platten bzw. Pool-Layout? Wenn da mehr Spindeln oder ein SSD-Cache drin sind, erklärt das schon den Unterschied.
 
  • Like
Reactions: news
Ja. Die 99% waren auch die Ursache der aktuellen Intervention...

Leider ist es manchmal problematisch den Speicherbedarf bei PBS "vorauszuahnen". Vor allem wenn das Backup plötzlich sehr viel größer ausfällt als im Normalbetrieb. Hierzu wäre eine Statistik hilfreich, die einfacher zu lesen ist, als die vorhandenen Graphen oder die Backuplogs...

An der Fragmentierung kann man vermutlich bei dieser Nutzung nichts ändern, richtig? Sind ja nur winzige Dateien... Ich habe am Standard nichts geändert,
aber auch schon gelesen, daß hier noch eine Anpassung der Chunkgröße einen Unterschied machen könnte?!

Wir sind auf dem aktuellen Stand (4.2.8); dass mit der "gc-cache-capacity" hatte ich eben auch schon im Forum gelesen, wollte es aber während der
laufenden GC's nicht ändern. Werde ich später nachholen...

Danke dir für deine erste Einschätzung!
 
Last edited:
PBS funktioniert auch ohne die atime Eigenschaft. Ich lasse PBS zB. ohne Probleme in einem CT laufen welcher noatime nutzt. Ansonsten halt relatime.
Ich bin nicht sicher wie viele Einbüße diese Art des Passthroughs hat. Empfohlen wird es für ZFS ja oftmals nicht, mit "virtualisierter Hardware" zu arbeiten. Es gibt so auch keine Smart Werte innerhalb der VM.
Ich würde entweder PCI(e) Passthrough oder ein CT testen. Ich nutze schon lange keine Festplatten mehr, aber ich habe damals mit ZVOLS auf ihnen schlechte Erfahrungen gemacht. Ich würde der VM also hier auch keine virtuelle Festplatte geben (ext4 intern).
Vielleicht ist das hier hifreich, um zu sehen wo genau der Engpass sein könnte.
Wie sieht denn das Setup auf dem NAS genau aus?
Das sind momentan alles erst mal nur ein paar Gedanken, keine konkreten Änderungsvorschläge :)
 
Last edited:
Guten Mogren,

bei mir setze ich immer noch, bei zfs und hdd Nutzung, auf ein vdev zfs special device mit ssd im zfs mirror mit n>1 SSD.

Mein Proxmox BS hat ein 4x HDD Setup, Raid 10, mit 2x 2 HDDs und ein vdev zfs special device im zfs mirror n=4 mit 2x SDD und 2x NVMe Partitionen.
auf dem zfs special device liegen bei mir nur die zfs Metadaten mit zfs small block size = 0, d.h. keine Dateien landen nicht im zfs ssd/ nvme pool.

Wie schon durch @Bu66as geschrieben, auf den Füllgrand vom < 80% des Maximumes achten.
 
Ach so das NAS - habe ich vergessen... :rolleyes:

Das fragliche Volume auf dem NAS besteht aus einem exklusiv für dieses Backup genutzten RAID1 (HDD) ohne SSD-Puffer und ist per NFS angebunden.
 
Last edited:
Man beachte das HowTO zum Proxmox BS.

Schau dir bitte mal deine Chunkgröße und den Deduplication Factor deines ZFS Datasets für den Proxmox BS an.

Die Chunkgröße kann bis 4 MByte groß werden. ZFS kann komprimieren, ist da aktiv auf deinem zfs pool?
 
@Impact hat recht, da war ich zu vorsichtig. PBS setzt die atime bei der GC über utimensat, das klappt auch mit relatime/noatime. Die Chunkgröße kannst du in PBS selbst nicht einstellen, die ist fest (bis 4 MiB, bei VM-Images feste 4 MiB-Chunks). Was du aber anpassen kannst, ist die recordsize vom ZFS-Dataset. Default sind 128K, für einen PBS-Datastore nehm ich gern 1M:
Code:
zfs get recordsize,compression,dedup local_backupstorage_xxx
zfs set recordsize=1M local_backupstorage_xxx
Das wirkt nur auf neu geschriebene Chunks, der Bestand wird mit der Zeit durch Prune/GC angepasst. Post #7: ZFS-Dedup sollte da aus sein, PBS dedupliziert schon selbst, und ZFS-Dedup kostet nur RAM und IO. lz4 als Compression kann an bleiben, bringt aber wenig, weil die Chunks schon mit zstd komprimiert sind.

Zur Vorhersage: Unter Datastore → Summary gibt es eine Schätzung, wann der Datastore voll ist. Ist nicht perfekt, aber besser als in den Logs zu suchen. Wie voll ist denn das Volume auf dem NAS im Vergleich? Wenn da noch deutlich mehr Luft ist, würde das den Unterschied bei gleichem RAID1-HDD-Unterbau ganz gut erklären.
 
Das Volume auf dem NAS ist meist ähnlich bzw. sogar noch schneller voll, da die nutzbare Kapazität geringfügig geringer ist (deshalb auch unterschiedliche Retentionseinstellungen). Warum auch immer...

Aber es ist kein ZFS, sondern BTRFS (Synology SHR).

Ich habe eben spaßeshalber die Datenblätter der verwendeten HDD's angeschaut. Es sind jeweils 2x 16TB unterschiedlicher Hersteller (Seagate vs. WD), aber die Leistungsdaten sind vergleichbar.
 
Last edited:
@mhert frade Dich bitte mal, wie viele Kopfbewegungen / Sektorensuchen notwendig sind.
Ausgehend von diesen Fakten:
HDD: 4 KB Sektorgröße
ZFS Recordsize 128 KB = 32 * 4 KB
max. PBS chunk size 4 MB = 4096 KB = 32 * 128 KB = 32² * 4 KB = 2^10 * 4 KB
Dazu kommen dann noch die zu speichernden ZFS Metadaten.

Wie geschrieben, getrennte ZFS Speichermedien hilft für die IOPs!
 
Last edited:
Das heißt dann im Umkehrschluß: ZFS ist für sowas eigentlich völlig ungeeignet ("Overkill"), auch in Betrachtung der 80%-Regel? Wäre es sinnvoll aus Perfomancegründen auf ein anderes Dateisystem umzustellen, beispielsweise auf ext4?

Es geht ja eigentlich nur um eine Spiegelung bei Ausfall eines Datenträgers.

@news: Du meinst "special device", wenn du "getrennte ZFS Speichermedien" schreibst, oder?
 
Last edited:
Nö, ich will schon die Sicherheit eines zfs raid1 - mirror oder zfs raidZn und alle weiteren Möglichkeiten der Selbstheilung nutzen können.
Das fehlt dir alles mit ext4.