

[SOLVED] Ceph S3 Storage und Veeam M365 Backup

Ingo S

Renowned Member
Oct 16, 2016
367
55
93
43
Moin zusammen

Ich versuche ein M365 Backup Repository einzurichten, das unseren Ceph Cluster als S3 kompatiblen Objekt Storage nutzt. Hat jemand von euch schonmal sowas gebaut?
Ich habe mich dazu durch die Anforderungen aus der Veeam Dokumentation gewühlt und den Rados GW, den Pool und den Bucket entsprechend konfiguriert.
->
  • AWS Signature Version 4 (ist wohl default?)
  • Pool "veeam" angelegt
  • Bucket "M365 Backup" angelegt, der den Pool veeam als Storage Ziel nutzt
  • S3 Object Lock ist aktiviert
  • Versioning ist aktiviert
  • keine default retention
  • keine Lifecycle Regeln
  • Access_Key und Access_Secret auf der Konsole verifiziert
Retention lock funktioniert:
JSON:
[ingo@]$ aws --endpoint-url https://veeam-s3.langeoog.de:7443 s3api get-object-retention --bucket veeam-m365-backup-repo --key test-locked.txt
{
    "Retention": {
        "Mode": "COMPLIANCE",
        "RetainUntilDate": "2026-11-01T00:00:00.000000000Z"
    }
}
JSON:
root@pve2:~# radosgw-admin bucket stats --bucket=veeam-m365-backup-repo
{
    "bucket": "veeam-m365-backup-repo",
    "tenant": "",
    "versioning": "enabled",
    "zonegroup": "0374348d-13fc-4df8-9a39-64695b7eaae7",
    "placement_rule": "default-placement",
    "explicit_placement": {
        "data_pool": "",
        "data_extra_pool": "",
        "index_pool": ""
    },
    "id": "e59b3052-49c4-490e-97b1-d2930ab5877d.36132281.1",
    "marker": "e59b3052-49c4-490e-97b1-d2930ab5877d.36132281.1",
    "index_type": "Normal",
    "index_generation": 0,
    "reshard_status": "None",
    "judge_reshard_lock_time": "0.000000",
    "object_lock_enabled": true,
    "mfa_enabled": false,
    "owner": "veeam-s3",
    "num_shards": 11,
    "ver": "0#1,1#1,2#1,3#1,4#2,5#2,6#3,7#1,8#3,9#1,10#2",
    "master_ver": "0#0,1#0,2#0,3#0,4#0,5#0,6#0,7#0,8#0,9#0,10#0",
    "max_marker": "0#,1#,2#,3#,4#,5#,6#,7#,8#,9#,10#",
    "usage": {
        "rgw.main": {
            "size": 15,
            "size_actual": 12288,
            "size_utilized": 15,
            "size_kb": 1,
            "size_kb_actual": 12,
            "size_kb_utilized": 1,
            "num_objects": 7
        }
    },
    "mtime": "2026-10-30T12:08:33.293665Z",
    "creation_time": "2026-10-29T12:13:28.627346Z",
    "bucket_quota": {
        "enabled": false,
        "check_on_raw": false,
        "max_size": -1,
        "max_size_kb": 0,
        "max_objects": -1
    },
    "read_tracker": 2
}
Code:
[client.rgw.pve2]
    host = pve2
    keyring = /var/lib/ceph/radosgw/ceph-rgw.pve2/keyring
    log file = /var/log/ceph/ceph-rgw.pve2.log
    rgw frontends = beast ssl_port=7443 ssl_certificate=/etc/ceph/ssl/rgw.pem
    rgw realm = default
    rgw zonegroup = default
    rgw zone = default
Code:
rule veeam {
    id 1
    type erasure
    step set_chooseleaf_tries 5
    step set_choose_tries 100
    step take default
    step chooseleaf indep 0 type host
    step emit
}

Alles was mir einfiel, was ich testen kann, funktioniert auf der Konsole. Ich kann Objekte hochladen, Ordner anlegen, retention setzen, die Daten landen im richtigen Pool, aber wenn der Veeam Assistent für das Backup Repository einen Ordner für das Repo anlegen will bekomme ich diesen Fehler hier:
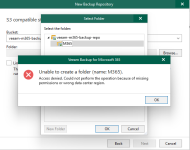
1793694687825.png
Und eigentlich müsste der Assistent auch dort zwei Ordner in dem Bucket anzeigen. Aber der ist auch nicht zu sehen. Auf der Konsole existieren sie aber:

Code:
[ingo@]$ aws --endpoint-url https://veeam-s3.langeoog.de:7443 s3 ls s3://veeam-m365-backup-repo/
                           PRE M365/
                           PRE Veeam/
2026-10-30 12:36:35          5 test-locked.txt
2026-10-29 14:45:50          5 test.txt
Ich hoffe jemand hat eine Idee wie ich den Fehler finde.
 
Der Screenshot zeigt "Access denied ... missing permissions or wrong data center region". Schau dir die Region an. Bei SigV4 steckt die Region mit in der Signatur. Wenn Veeam da us-east-1 o.ä. mitschickt und die Zonegroup im RGW einen anderen api_name hat, kann das schiefgehen, während die aws cli mit ihrer eigenen Region-Einstellung durchläuft. Schau mal, was hier bei api_name steht:
Code:
radosgw-admin zonegroup get | grep -E '"name"|api_name'
und ob das zu der Region passt, die im Veeam-Objektstorage-Account eingetragen ist. Schau am besten in den Logs nach: dreh debug_rgw hoch (ceph config set client.rgw.pve2 debug_rgw 20) und lies im ceph-rgw.pve2.log mit, während der Assistent den Ordner anlegen will. Da siehst du den genauen Request und warum er mit 403 abgelehnt wird. Danach den Debug-Level wieder zurücksetzen, sonst läuft das Log voll.

Übrigens, die Ordner M365/ und Veeam/ hast du selbst per CLI angelegt? Veeam braucht eigene Metadaten in den Ordnern und mag vorher angelegte Strukturen nicht. Nimm die Testobjekte raus und lass Veeam den Ordner selbst anlegen.
 
  • Like
Reactions: Ingo S
Danke dir schonmal für deinen Input.
Über die Region war ich auch schonmal gestolpert. Bei meinen ersten Versuchen hatte ich sie leer gelassen, aber dann herausgefunden, dass sie bei mir wohl "default" heißt.
Code:
root@pve2:~# radosgw-admin zonegroup get | grep -E '"name"|api_name'
    "name": "default",
    "api_name": "default",
        "name": "default",
        "name": "default-placement",
Auch wenn ich "default" als Region angebe bekomme ich die gleiche Meldung.

Ich hab mal explizit den Vorgang aus dem Log gefischt in dem Moment wo der Assistant den Ordner anlegen will und den Fehler wirft und als Datei angehängt.

Vielleicht ist da was drin zu sehen. Aber ich sehe darin keine Fehler.
Das einzige was auffällt ist, dass Veeam scheinbar nach einem Ordner /Veeam/Backup365/ filtert. Mein Verdacht ist, dass er diesen Ordner erwartet, dieser aber nicht existiert. Allerdings ist doch der Assistent gerade dazu da, die Ordnerstruktur im Bucket anzulegen.
Entweder habe ich da irgendwas nicht richtig verstanden, oder es ist irgendwie unlogisch...
 

Attachments

Der Request im Log ist durchgelaufen: Signatur passt mit Region "default", ACL greift, am Ende http_status=200. Das ist nur das erste Listing, und dass da 0 Einträge rauskommen, ist normal. Veeam legt seine Repos unterhalb von Veeam/Backup365/<Ordnername>/ an. Solange da noch nichts existiert, ist der Prefix leer. Deine selbst angelegten Ordner sieht der Assistent nicht, weil die auf Root-Ebene liegen. Region und Auth kannst du damit abhaken.

Der eigentliche Fehler steckt dann in einem der nächsten Requests, wenn Veeam wirklich schreibt (PUT, evtl. mit Object-Lock-Headern) oder die Lock-/Versioning-Config abfragt. Lass den Assistenten nochmal laufen und schau dann nach allem, was nicht 200 ist:
Code:
grep 'beast:.*192.168.1.235' /var/log/ceph/ceph-rgw.pve2.log | grep -vE '" 20[0-9] '
Mit der request_id aus der Zeile findest du dann den ganzen Block zu dem Request. Welche Operation ist das und welcher Fehlercode kommt zurück? IIRC macht Veeam aus so ziemlich jedem 4xx "Access denied ... wrong region", die Meldung selbst hilft also wenig. Welche Ceph-Version läuft bei dir? Bei neueren S3-Clients mit Checksum-Headern ist RGW je nach Version manchmal zickig.
 
  • Like
Reactions: Ingo S
Okay okay ich glaube ich habe eine heiße Spur:
Ich hatte vergessen, dass wir für HA über einen HAProxy im Round Robin auf zwei verschiedenen Servern mit dem Cluster kommunizieren und der Fehler vielleicht deshalb nicht im Log drinne ist. Habe daher den zweiten Endpoint deaktiviert, damit alles auf pve2 aufläuft und siehe da, im Log findet sich plötzlich das hier:
Code:
2026-11-03T11:50:06.652+0100 737e5cc666c0  5 Signature rejected: 'content-type' supplied but not in CanonicalHeaders.
2026-11-03T11:50:06.652+0100 737e5cc666c0 20 req 442829267306320233 0.000000000s s3:put_obj rgw::auth::s3::LocalEngine denied with reason=-1
2026-11-03T11:50:06.652+0100 737e5cc666c0 20 req 442829267306320233 0.000000000s s3:put_obj rgw::auth::s3::AWSAuthStrategy denied with reason=-1
[...]
2026-11-03T11:50:06.652+0100 737e5cc666c0 10 failed to authorize request
2026-11-03T11:50:06.652+0100 737e5cc666c0 20 req 442829267306320233 0.000000000s op->ERRORHANDLER: err_no=-1 new_err_no=-1
2026-11-03T11:50:06.652+0100 737e5cc666c0 10 req 442829267306320233 0.000000000s cache get: name=default.rgw.log++script.postrequest. : hit (negative entry)
2026-11-03T11:50:06.652+0100 737e5cc666c0  2 req 442829267306320233 0.000000000s s3:put_obj op status=0
2026-11-03T11:50:06.652+0100 737e5cc666c0  2 req 442829267306320233 0.000000000s s3:put_obj http status=403
2026-11-03T11:50:06.652+0100 737e5cc666c0  1 ====== req done req=0x737d269364a0 op=put_obj bucket= status=0 http_status=403 latency=0.000000000s request_id=tx0000006253edf55f09169-006ae9bc5e-37799671-default ======
2026-11-03T11:50:06.652+0100 737e5cc666c0  1 beast: 0x737d269364a0: 192.168.1.235 - - [03/Nov/2026:11:50:06.652 +0100] "PUT /veeam-m365-backup-repo/Veeam/Backup365/Repo01/ HTTP/1.1" 403 212 - "APN/1.0 Veeam/1.0
Offenbar kommuniziert Veeam hier nicht standard konform und bindet den content-type nicht in die signature ein, was unser S3 Backend dann mit einer 403 quittiert.
Schön schön... *seufz*
Was kann ich da tun? Kann ich meinem Rados Gateway irgendwie sagen, das das okay ist? Muss ich einen Bug Report an Veeam senden? :rolleyes:
 
  • Like
Reactions: Johannes S
Das liegt dann an Veeam. Laut SigV4-Spec muss content-type mit in die CanonicalHeaders, wenn der Header im Request steckt. Veeam schickt ihn mit, signiert ihn aber nicht, und RGW lehnt das korrekt ab. Würd ein Ticket bei Veeam aufmachen und die Logzeile mitschicken.

Du hast ja den HAProxy davor. Da der Header nicht signiert ist, kannst du ihn dort für Veeam rauswerfen, ohne die Signatur kaputtzumachen, z.B.

Code:
acl is_veeam hdr_sub(User-Agent) Veeam
http-request del-header Content-Type if is_veeam

Ist ein Hack, die Objekte landen dann ohne Content-Type im Bucket. Bei Ordner-Objekten ist das egal, ob Veeam die Datenblöcke später damit anfängt, weiß ich nicht. Erst mal testen, ob Veeam damit durchkommt.

Und noch was: Laufen auf beiden RGW-Instanzen die gleichen Ceph-Versionen? Sonst wird's später kompliziert, wenn mal der eine und mal der andere antwortet.
 
Oi... yikes, warum finde eigentlich immer ICH solche Bugs :rolleyes::D

Danke dir!
Da der HAProxy im TCP Mode läuft wird das leider nichts mit dem Entfernen des Header. Dann mache ich mal ein Ticket bei veeam auf.
(Ich wette, wenn ich statt "S3 compatible" den original Amazon S3 Storage Typ ausgewählt hätte, träte das Problem nicht auf, aber das Einrichten würde an anderen Stellen dann fehlschlagen...)

Wir halten auf unserem Ceph Cluster immer alle Nodes auf der gleichen Version, auch um eben genau solche inkonsistenzen zu vermeiden.
 
  • Like
Reactions: Johannes S
Update:
Die Ursache dieser ganzen Misere ist ein Fix für CVE-2026-54330 der die SigV4 zu strikt auslegt um die Schwachstelle zu schließen.
Die Regression wird mit dem Release 20.2.5, das gestern angekündigt wurde, behoben -> https://lists.ceph.io/hyperkitty/list/ceph-users@ceph.io/thread/B3QDGSXPGMYMEKJWPVME5NWEBUTVKF4B/ -> "Fixed SigV4 signature handling so Content-Type is no longer alwaysrequired in the signature and x-amz-content-sha256 need not be a signed header."

Bis das Release 20.2.5 in PVE ankommt, funktioniert ab Ceph Version 20.2.4 die folgende config option:
Code:
ceph config set client.rgw rgw_sigv4_insecure true --force
Findet ihr unter https://docs.ceph.com/en/latest/security/CVE-2026-54330/#critical-upgrade-steps ganz unten

Falls sich Ceph beschwert:
Error EINVAL: unrecognized config option 'rgw_sigv4_insecure'
fügt ein --force an den Befehl.

Nach dem Update auf 20.2.5 nicht vergessen die insecure Option wieder zu entfernen:
Code:
ceph config rm client.rgw rgw_sigv4_insecure
 
  • Like
Reactions: Johannes S