PVE host crashed in unregelmäßigen Abständen

DonCa

Member
Sep 9, 2023
15
0
6
Guten Morgen,

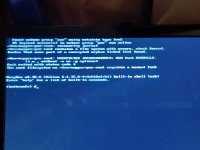
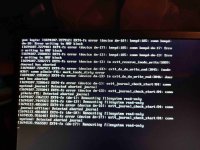
ich hab ein Problem bei meinem PVE host auf Intel Nuc 6. Das Betriebssystem crashed leider immer wieder. Das letzte Mal war es im Oktober und November letztes Jahr. Nun leider wieder gestern. In den S.M.A.R.T Daten kann ich keine Fehler finden. Der Verschleiß der SSD von Kingston ist auf 5%. Der Proxmox Backup Server schmeißt auch alle 2..3 Tage eine fehlerhafte Verifizierung raus meinstens bei meinem VM wo Homeasssistant drauf ist wegen falschen Chunks.

Über "df -h" kann ich keinen vollen Speicherplatz finden. Ich möchte allerdings nicht ausschließen, dass ich damals bei der Einrichtung etwas unsinnvoll eingestellt habe bei der Speichererstellung.

root@pve:/# df -h
Filesystem Size Used Avail Use% Mounted on
udev 12G 0 12G 0% /dev
tmpfs 2.4G 2.9M 2.4G 1% /run
/dev/mapper/pve-root 98G 13G 81G 14% /
tmpfs 12G 37M 12G 1% /dev/shm
tmpfs 5.0M 0 5.0M 0% /run/lock
efivarfs 128K 72K 52K 59% /sys/firmware/efi/efivars
/dev/sda2 1022M 12M 1011M 2% /boot/efi
/dev/fuse 128M 28K 128M 1% /etc/pve
overlay 98G 13G 81G 14% /var/lib/docker/overlay2/71fc72efe7242e5cf1947ee13446676de7198a837700be348cda157f9bef0f84/merged
//192.168.3.124/Backup 3.6T 404G 3.2T 12% /mnt/pve/Mira
tmpfs 2.4G 0 2.4G 0% /run/user/0


Bislang ist mir das in 2 Jahren 4 mal passiert und ich konnte dann immer über initramfs noch rein kommen und über fsck die Systemdateien reparieren. Aber das kann ja kein Zustand sein. Ich will auch sssssehr ungerne den kompletten Host neu machen. Auf ihm selber habe ich soweit nichts angepasst außer, dass Heimdall vom Host selbst mit läuft.

Hier würde ich erstmal liebend gern mit der Analyse anfangen. Es gibt bestimmt noch seeeehr viel mehr zu checken. Ich will das bloß mal jetzt endlich angehen, weil mein komplett Hof am Homeassistant dran hängt und auch an meinen Containern (Pihole, DokuWiki, nodered, usw.), weswegen ich das System auch nicht einfach so neu aufsetzen möchte.

Dass der Backup Server nicht erfolgreich verifizieren kann kann vielleicht am 30m langen LAN Kabel liegen, aber das hatte ich bislang ausgeschlossen, weil über die gleiche Leitung noch 2 OMV Server problemlos laufen.

Tut mir leid dass die Bilder so schlecht sind, der schlechte Autofokus von meinem Ersatzhandy verträgt sich nicht so richtig mit meinem 11" Notfalldisplay ^^


Ich habe auch grade noch einen alten Post von mir gefunden.
Allerdings muss doch Proxmox damit klarkommen, dass die Platten mit der Zeit abrauchen?
 

Attachments

  • 20261117_180051.jpg
    20261117_180051.jpg
    474.4 KB · Views: 0
  • 20261117_175518.jpg
    20261117_175518.jpg
    471 KB · Views: 0
Last edited:
An der Empfehlung vom anderen Thread hat sich nichts geändert. Ich würde hier direkt auch wieder auf billige Consumerhardware tippen, denn genau in die Richtung zeigen die Fehler. Schau mal in deine Systemlog vorm Ausfall und prüfe ob da schon Fehler mit dem Storage zu finden sind.

Dass der Backup Server nicht erfolgreich verifizieren kann kann vielleicht am 30m langen LAN Kabel liegen
für 1 GBE gilt IMHO 100m mit guten Kabeln ohne Verlusste ... die Verluste sind aber Durchsatz, nicht Pakete. Wenn Pakete verloren gehen, werden die neu übertragen und das müsste in den Fehlerzählern der Schnittstelle zu finden sein. Prüfe das bitte mal nach.
 
  • Like
Reactions: ThoSo
Moin. Ja auf Dauer wird die Festplattenart keine Lösung sein. Am liebsten würde ich ja wieder auf HDD gehen, aber ich weiß nicht ob eine HDD das schafft in der Dimension wie mein Homeassistant läuft. Nach wie vor würde mich ja zugerne interessieren, wie mit dem Thema Wearout systemseitig umgegangen wird. Jede SSD hat ja ein Wearout in gewisser Zeit.

Nov 17 05:38:32 pve smartd[686]: Device: /dev/sda [SAT], SMART Usage Attribute: 194 Temperature_Celsius changed from 31 to 32
Nov 17 05:46:42 pve systemd[1]: Starting man-db.service - Daily man-db regeneration...
Nov 17 05:46:42 pve systemd[1]: man-db.service: Deactivated successfully.
Nov 17 05:46:42 pve systemd[1]: Finished man-db.service - Daily man-db regeneration.
-- Reboot --
Nov 17 18:08:42 pve kernel: Linux version 6.8.12-43-pve (build@proxmox) (gcc (Debian 12.2.0-14+deb12u1) 12.2.0, GNU ld (GNU Binutils for Debian) 2.40) #1 SMP PREEMPT_DYNAMIC PMX 6.8.12-43 (2026-08-18T13:29Z) ()

Das Systemlog macht mir auch Rätsel. In meiner Pause Richtung 12 hatte ich noch voll an der VM gearbeitet. 14:46 wollte ich dann die Heizung anmachen und bemerkte, dass Heimdall und Proxmox nicht mehr on sind. Homeassistant arbeitet für gewöhnlich dann noch eine Weile für sich weiter bis einzelne Entitäten ausfallen und dann die gesamte VM. Der Reboot Eintrag muss dann vom späteren Zeitpunkt stammen wo ich mich gegen 18 Uhr an die Reparatur über den initramfs gemacht hatte.

Zu meiner Backup-LAN-Leitung vom Proxmox Backup Server (Läuft auf einem separaten Intel Nuc 6) konnte ich tatsächlich noch keine Einbüßen dies bezüglich feststellen. Am Anfang hatte ich da Stress aber das lag an einer unmittelbaren Drehstromleitung. An dem Netz hängt noch Openmediavault der zum anderen Openmediavault (wo auch der PVE Host ist) der über iPferf3 GB/s schafft.
 
Moin

Da ich bei Deinem anderen Beitrag ja auch schon etwas zu dem Thema Kingston SSD gepostet hatte, incl. einem Screenshot von der Diskübersicht.
Nach wie vor würde mich ja zugerne interessieren, wie mit dem Thema Wearout systemseitig umgegangen wird. Jede SSD hat ja ein Wearout in gewisser Zeit.
Ich/Man weiß ja weiterhin nicht welches Kingston Modell Du da genau im Einsatz hast, aber es müssen auch nicht "zwangsweise" Enterprise SSD sein. Nur sollte man bei der "Nicht Enterprise Klasse" dann eben nicht quasi die Einstiegsklasse mit dem günstigsten Preis nehmen.

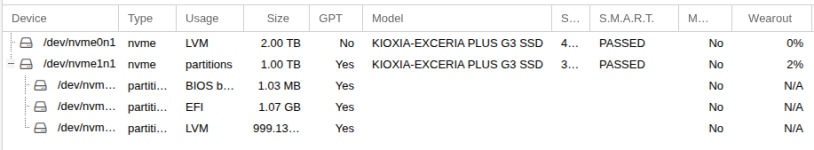
Ich habe hier bei meinem PVE Host innerhalb des letzten Jahres zwar Veränderungen bei den Disk vorgenommen - was aber auch nichts mit irgendwelchen Defekten zu tun hatte - aber eine KIOXIA NVMe SSD ist weiterhin im System.

Alter Screenshot vom letzten Jahr:

Proxmox_Disk_alt.png

Neuer Screenshot von eben:

Proxmox_Disk.png

Wie man sehen kann hat sich der Wearout Wert bei der 1TB KIOXIA NVMe SSD innerhalb von 1 Jahr gerade mal um 2 % erhöht. Auf dem PVE Host läuft ebenfalls seit mehreren Jahren HA in einer VM.

Anm.: Die jetzt neu hinzugekommene Crucial CT500P1 war vorher bereits mehrere Jahre in einem PC im Einsatz.

Wie gesagt habe ich keine Ahnung welches Kingston Modell da bei Dir jetzt im Einsatz war und ob Proxmox tatsächlich für den Ausfall verantwortlich ist, aber wie schon gesagt laufen auch Nicht Enterprise (NVMe)SSD mit PVE problemlos über Jahre hinweg.

Anm.: Wie das dann bei einer Nutzung mit ZFS aussieht kann ich nicht beurteilen, da ich das nicht nutze.

VG Jim
 
Last edited:
Bei älteren Intel NUCs hilft bei sporadischen Freezes oft, C-States im BIOS zu begrenzen oder intel_idle.max_cstate=1 in GRUB zu setzen. Die NUCs haben im tiefen Sleep unter Linux öfter mal Hänger.
 
  • Like
Reactions: ThoSo
Wenn das immer wieder mit der gleichen SSD passiert - so liest sich das für mich - dann würde ich die SSD wechseln. Backup machen und gut. Auf dem Zwergen-PC wirst du ja kein ZFS nutzen, hoffe ich zumindest, und ausgelutscht ist die SSD sicher auch noch nicht. Für mich hat sie aber einen Hau.

Energiesparkram hat man ja hoffentlich sowieso alles abgeschaltet. Wann soll ein Server sich denn schlafen legen?
 
  • Like
Reactions: ThoSo
ich hab ein Problem bei meinem PVE host auf Intel Nuc 6. Das Betriebssystem crashed leider immer wieder. Das letzte Mal war es im Oktober und November letztes Jahr.
Wurde in der Zeit der PVE host immer Softwareseitig aktualisiert oder läuft der noch auf einem "veralteten" Patchstand ?

Bislang ist mir das in 2 Jahren 4 mal passiert und ich konnte dann immer über initramfs noch rein kommen und über fsck die Systemdateien reparieren. Aber das kann ja kein Zustand sein. Ich will auch sssssehr ungerne den kompletten Host neu machen. Auf ihm selber habe ich soweit nichts angepasst außer, dass Heimdall vom Host selbst mit läuft.

Hier würde ich erstmal liebend gern mit der Analyse anfangen. Es gibt bestimmt noch seeeehr viel mehr zu checken. Ich will das bloß mal jetzt endlich angehen, weil mein komplett Hof am Homeassistant dran hängt und auch an meinen Containern (Pihole, DokuWiki, nodered, usw.), weswegen ich das System auch nicht einfach so neu aufsetzen möchte.

Wenn die Kiste SO wichtig ist und der komplette Hof daran hängt, würde ich mir konzeptionell dahingehend Gedanken machen, und einen "richtigen" Server planen und den alten auf den neuen sauber migrieren. Anschließend kann der alten Kasten auseinander genommen werden, inkl. neu aufsetzen wenn das dann noch wichtig wäre.

Du kannst ein Hardware- und/oder Software Problem haben. Analyse ist gut, wenn das ich einer überschaubaren Zeit zum Ziel führt. Dazu gehört auch, das der Fehler reproduzierbar ist.
Poste doch bitte einmal das Journal/Log mit den Einträgen, wo die Kiste gecrashed ist - vielleicht ist da etwas auffälliges zu sehen.
 
Moin. Ja auf Dauer wird die Festplattenart keine Lösung sein. Am liebsten würde ich ja wieder auf HDD gehen, aber ich weiß nicht ob eine HDD das schafft in der Dimension wie mein Homeassistant läuft. Nach wie vor würde mich ja zugerne interessieren, wie mit dem Thema Wearout systemseitig umgegangen wird. Jede SSD hat ja ein Wearout in gewisser Zeit.
Ich hab' 16 Jahre alte Enterprise SSDs im Einsatz die erst 15% ihrere Reserven verbraucht haben. Das ist im Enterprise-Umfeld kein Thema. Im Consumer- und Prosumerumfeld sind die Änderungsgrößen im Flash meist im hohen 3-Stelligen KB, niedrigen MB Bereich und bei Enterprise SSDs bei 4, 8 oder 16 KB, sodass wenn ein Block auf einer Enterprise SSD geändert, wird, schreibt er halt ein paar KB, bei einer Consumer viel viel mehr. Daher kann man dort dem Wearout-Indikator zuschauen. Das ist nur ein großer Unterschied, gibt noch mehr, die interessieren jetzt aber nicht unbedingt für die Diskussion (benutze die Suchfunktion wenn du gefühlt 100 Threads zu dem Thema lesen willst, dieser gehört auch dazu).
Kein Mensch setzt heutzutage noch auf Festplatten. Ich hab glaub ich seit über 10 Jahren keine neue Festplatte mehr in der Hand gehabt.

... und aus Jahrzehner Erfahrung kann ich dir bei egal welchem OS sagen. Ist die Hardware kacke, schmiert alles irgendwann ab. Problem ist diese Hardware zu finden und natürlich gehört Enterprise Hardware eher dazu als irgendein Mini-Desktop-Teil. Das mit dem C-State von @BrickPelican ist ein guter Einwand. Immer im BIOS auf Performance stellen (das ist dann lustigerweise nicht mehr Energiekonform mit Energy Star, aber der Rechner läuft halt).

Kauf dir einfach gebrauchte Enterprise SSDS und gut ist ... zwei natürlich, wegen RAID1 und ja, die sind aktuell leider - wie alles - SAU teuer. Ich weiß noch, da hab ich knapp 35 Euro für ne 960 GB Samsung bezahlt (PM oder sogar SM893). Das waren noch Zeiten.